Mary Hyun-Sook Lee, advocaat in Ontario, diende een processtuk in met vier verwijzingen naar jurisprudentie. Drie van die zaken bestonden niet. De vierde bewees het tegenovergestelde van wat zij wilde aantonen. (Law Gazette)
De fout zat niet in het AI-antwoord
Een taalmodel dat een rechtszaak verzint, is geen nieuws meer. Het is een bekende eigenschap: het model voorspelt wat een plausibele verwijzing is en levert die met dezelfde zelfverzekerdheid als een echte. Het nieuws zit in wat daarna gebeurde. Gevraagd door de rechter of zij ChatGPT had gebruikt, ontkende Lee dat. Daarna zei ze dat haar personeel het stuk had voorbereid, en vervolgens dat een rechtenstudent het had gedaan. Uiteindelijk bleek dat zij op dat moment geen assistenten of stagiairs in dienst had (NOS). Het tribunaal van de Law Society of Ontario noemde haar vertrouwen op verzonnen zaken roekeloos, maar zei zich vooral te storen aan de herhaalde leugens daarna (Law Times). De schorsing van zes maanden en de betaling van 10.000 Canadese dollar aan de Law Society volgden daarop.
Kijk naar de volgorde. Eén controle, het opzoeken van de vier zaken, had enkele minuten gekost en het probleem op dag één zichtbaar gemaakt. Zonder die stap kwam de fout in een officieel stuk terecht. Elke ontkenning daarna maakte de rekening hoger: eerst een verkeerde verwijzing, toen een leugen tegen de rechter, toen een tuchtzaak. Volgens de NOS ging Lee na haar ontmaskering opnieuw in de fout. Ze vroeg ChatGPT hoe ze zich op de tuchtzaak kon voorbereiden.
Waarom zeker klinkende tekst de controle uitschakelt
Een verzonnen verwijzing ziet er precies zo uit als een echte: een partijnaam, een rechtbank, een jaartal. Onze reflex om vloeiende, gestructureerde tekst serieus te nemen werkt hier tegen ons. Het AI-antwoord geeft geen enkel signaal dat het onzeker is, dus het signaal dat een mens normaal gebruikt om te besluiten tot controle, ontbreekt. De controle moet daarom een vaste stap in het werk zijn en geen kwestie van gevoel. Dat patroon beperkt zich niet tot Canada. In Nederland kregen drie advocaten een waarschuwing van de toezichthouders op advocaten omdat ze rechtszaken aanhaalden die niet bestonden of niet relevant waren, en twee van hen moesten een AI-cursus volgen (NOS). Een toezichthouder omschreef het kwalijkste als advocaten die overnemen wat AI produceert en het indienen zonder te controleren. Opvallend is de maatregel: een waarschuwing en een cursus.
Hetzelfde probleem op de schaal van het web
Wat in één processtuk misgaat, gebeurt ook op het web, alleen minder zichtbaar. Hoeveel online tekst door AI is gemaakt, weet niemand: een betrouwbare meting bestaat niet. Wel meetbaar is het gebruik in wetenschappelijke teksten. Een analyse van meer dan 15 miljoen biomedische samenvattingen uit PubMed schat dat minstens 13,5 procent van de samenvattingen uit 2024 met een taalmodel is bewerkt (Kobak e.a., Science Advances, 2025). Let op de formulering: dit is een ondergrens, en bewerken met een taalmodel is niet hetzelfde als verzinnen. Het betekent wel dat een publicatie niet meer vanzelf een onafhankelijke bron is. Wie beleid of advies op literatuur bouwt, moet nagaan wat er is onderzocht en niet alleen wat er staat.
Het tweede effect zit in de modellen zelf. Onderzoekers rond Ilia Shumailov lieten in Nature zien dat taalmodellen die herhaaldelijk worden getraind op door modellen gemaakte data onomkeerbare gebreken ontwikkelen: de uitersten van de oorspronkelijke verdeling verdwijnen, zeldzame maar relevante informatie raakt kwijt (Shumailov e.a., Nature, 2024). Het is dezelfde fout als in het processtuk, op grotere schaal: ongecontroleerde output wordt de input van het volgende systeem. Voor zover bekend vangen de grote ontwikkelaars dit op door zwaarder te cureren op menselijke data. Dat is geen geruststelling maar een kostenpost. Gecontroleerde, door mensen gemaakte bronnen worden schaarser en waardevoller, en leveranciers moeten steeds meer filterwerk verzetten om vervuiling buiten de deur te houden. Waar dat tekortschiet, ziet u het terug in de antwoorden die uw medewerkers elke dag gebruiken.
Het was niet alleen onwetendheid
Had een cursus Lee gered? Gedeeltelijk. Volgens het tribunaal had zij nauwelijks ervaring met ChatGPT en wist zij naar eigen zeggen niet dat hallucinaties bestonden (Law Times). Dat is een kennisgat, en training vult dat. Maar vier zaken opzoeken is basaal handwerk, ook voor wie niet weet hoe een taalmodel werkt. Dat zij het niet deed, noemde het tribunaal roekeloos. De leugens daarna vond het ernstiger. Dat tweede is geen kennisprobleem meer. Een cursus lost het eerste op en raakt het tweede niet. Daarvoor is een proces nodig waarin controleren niet vrijwillig is en verbergen duur.
Laat de zwaarte van de controle meegroeien met het risico
Niet elke tekst verdient dezelfde controle. Een tweede onafhankelijke bron voor elk intern verslag is onrealistisch zwaar en niemand houdt het vol. Een onderscheid in drie niveaus werkt wel:
- Laag risico (intern concept, brainstorm, eigen notities): lees kritisch en markeer de tekst als AI-concept. Een bronnencontrole is niet nodig.
- Middel (klantmail, rapport, presentatie): open bij elke feitelijke bewering de primaire bron, zoals de wettekst, het onderzoek of de cijfers. Controleer namen, datums en bedragen.
- Hoog (juridische stukken, financiële of medische besluiten, publicaties, alles wat een beslissing stuurt): primaire bron, een tweede onafhankelijke bron, controle door een tweede persoon en vastleggen wat is gecontroleerd.
Lee werkte in de derde categorie en handelde alsof zij in de eerste zat.
Maak controle aantoonbaar in het proces
Kennis zonder proces verdampt. Een beleid dat alleen in een document staat, wordt niet gevolgd. Het moet zitten in de systemen waarin mensen werken, en een medewerker moet kunnen laten zien dat een feit is gecontroleerd. Dat kan concreet:
- een verplicht veld in het dossier of de opdracht: bron geopend door wie, wanneer, met een link;
- een tweede paar ogen bij alles in de hoge categorie;
- een aangewezen eigenaar van de controle, bij naam bekend;
- een duidelijke afspraak: een fout melden kost niets, een fout verbergen heeft consequenties.
Dat laatste moet het management uitspreken en volhouden. Anders leert iedereen dat verbergen goedkoper is dan melden, en dat is precies de route die Lee nam.
Hoe wij dit aanpakken
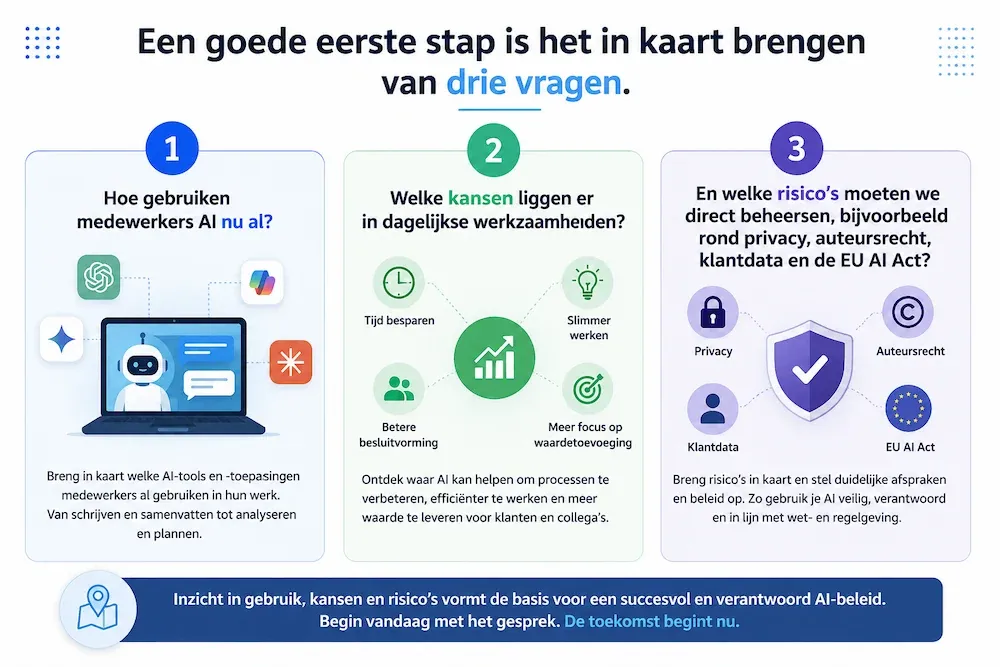
Training en proces horen bij elkaar. In onze AI-geletterdheidstraining oefenen deelnemers met AI-output uit hun eigen werk: wat klopt, wat is onzeker en welke bron moet ik openen voordat ik dit gebruik? Met de PERFECT-methode leren ze AI vragen om bronnen en om aan te geven waar het onzeker is. Daarna vertalen we dat naar werkafspraken in het AI-beleid: risiconiveaus, wie controleert en wat wordt vastgelegd. Wilt u die afspraken laten aansluiten op de documenten en systemen van uw eigen team, dan werkt AI training op maat met uw eigen werkprocessen. Voor een bredere verankering in klantopvolging, research en kennisbeheer bestaat de AI-transformatie. Een goede eerste stap is het in kaart brengen van drie vragen:
Tot slot
Het risico is niet dat AI zich vergist. Het risico is dat niemand is aangewezen om dat op te merken. Bekijk hoe u uw team AI-geletterd maakt.
Bronnen
- NOS: Advocaat haalt door AI verzonnen bronnen aan en beschuldigt niet-bestaande student
- NOS: Advocaten krijgen waarschuwing en moeten op cursus na verkeerd gebruik AI (22 februari 2026)
- Law Gazette: Canadian lawyer who misled judge about ChatGPT is suspended (24 juli 2026)
- Law Times: Out of character: tribunal explains six-month suspension of lawyer who lied about ChatGPT use
- Kobak, González-Márquez, Horvát en Lause (2025), Delving into LLM-assisted writing in biomedical publications through excess vocabulary, Science Advances 11(27)
- Shumailov e.a. (2024), AI models collapse when trained on recursively generated data, Nature 631
Veelgestelde vragen over AI en betrouwbare bronnen
Wat gebeurde er met de advocaat die door AI verzonnen jurisprudentie gebruikte?
De Canadese advocaat Mary Hyun-Sook Lee diende een processtuk in met vier verwijzingen naar rechtszaken. Drie bestonden niet en de vierde sprak haar eigen argument tegen. Omdat zij daarna meerdere keren loog over het gebruik van ChatGPT, is zij voor zes maanden geschorst.
Hoeveel van het internet is door AI gemaakt?
Niemand weet het precies, want er bestaat geen betrouwbare meting. Meetbaar is wel dat het gebruik van taalmodellen in wetenschappelijke teksten sterk is gegroeid. In 2024 was minstens 13,5 procent van de biomedische samenvattingen met een taalmodel bewerkt.
Wat is model collapse?
Model collapse is het verschijnsel dat AI-modellen slechter worden als ze herhaaldelijk worden getraind op tekst die andere AI-modellen hebben gemaakt. Onderzoek in Nature uit 2024 liet zien dat zulke modellen zeldzame, maar belangrijke informatie kwijtraken.
Kan ik zien of een tekst door AI is geschreven?
Niet betrouwbaar. Detectietools maken fouten, in beide richtingen. Een bruikbaardere vraag is of de tekst controleerbaar is: noemt hij bronnen die u kunt openen, geeft hij concrete voorbeelden en is er een herkenbare auteur?
Hoe controleer ik AI-antwoorden in mijn dagelijkse werk?
Stem de controle af op het risico. Lees een intern concept kritisch, open bij een rapport of klantmail de primaire bron en controleer namen, datums en bedragen, en laat bij juridische, financiële of publieke stukken ook een tweede bron en een tweede persoon controleren.